Scegli l'Assistente
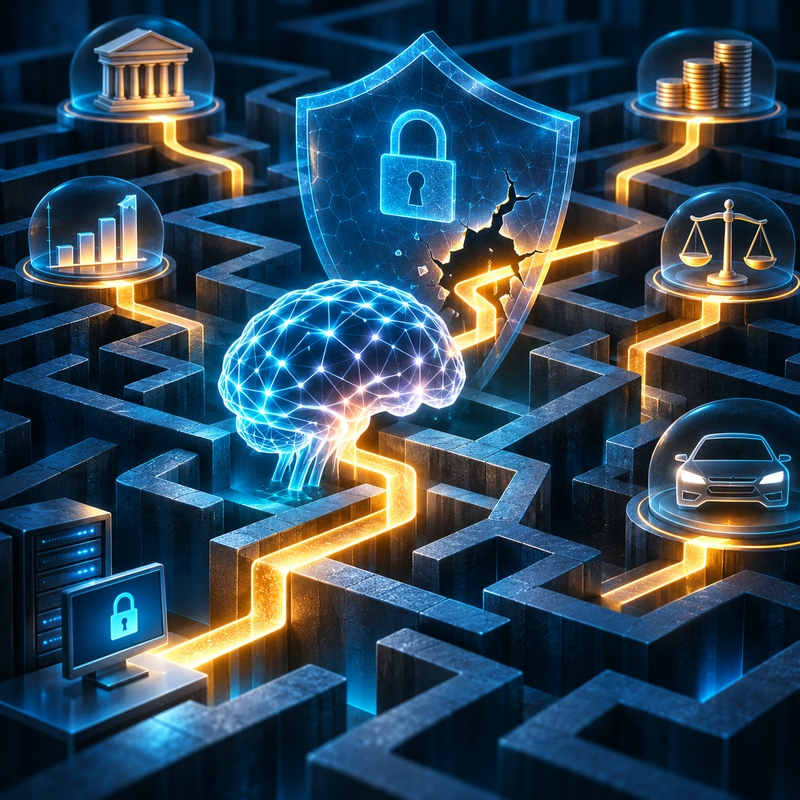
Oggi, però, l’hacking legato all’AI può assumere tre forme distinte: gli hacker possono attaccare i sistemi AI, utilizzare tale tecnologia per violare altri sistemi informatici oppure può essere la stessa AI a scoprire e sfruttare falle di sicurezza di propria iniziativa, anche senza aver ricevuto istruzioni per farlo.
A destare maggiori preoccupazioni sono soprattutto gli ultimi due scenari, in particolare quello in cui è la tecnologia stessa ad agire. Il sistema, infatti, potrebbe trovare il modo di aggirare le regole mentre cerca di portare a termine un compito, in modo del tutto indipendente.
L’AI porta l’hacking nella vita reale
L’argomento è stato sviluppato in un intervento di Bruce Schneier alla conferenza DEF CON 34, tenuta a Las Vegas dello scorso agosto.
Schneier, autore del libro A Hacker’s Mind del 2022, ha previsto uno scenario molto simile a quello odierno.
Lo scrittore ha spiegato come, nel 2026, non sia necessario attendere oltre per notare una svolta tecnologica concreta verso il nuovo significato di hacking.
Per comprendere il problema bisogna ampliare la definizione di tale parola.
Prendiamo per esempio il codice fiscale: stiamo parlando di informazioni al di fuori dell’ambito informatico, sebbene contenga un insieme di istruzioni.
Le sue possibili “vulnerabilità” sono le scappatoie normative, con gli exploit assumono la forma di strategie di elusione fiscale.
Chi le individua può essere un commercialista o un avvocato, non per forza un criminale informatico.
Il principio rimane però lo stesso, ovvero sfruttare una possibilità consentita dal sistema, ma contraria allo scopo per cui le regole erano state concepite.
Un hack, quindi, non coincide sempre con la violazione esplicita di una norma.
Può rispettare alla lettera le regole e, nello stesso tempo, sovvertirne l’intento.
La stessa dinamica si ritrova nello sport professionistico, nei programmi fedeltà, nella finanza e nella politica.
Gli esseri umani hanno sempre cercato questi cavilli.
La novità introdotta dall’AI è la possibilità di esaminare un numero enorme di regole e combinazioni in tempi ridotti, senza i limiti di tempo ed esperienza che condizionano una persona.
I sistemi attuali sono già molto efficaci nell’individuare vulnerabilità nel codice e nel trasformarle in exploit.
Schneier ritiene però che la conseguenza più rilevante sarà l’estensione di queste capacità a sistemi non informatici, come il diritto tributario, le regole finanziarie e le procedure democratiche.
La seconda eventualità è, se possibile, più insidiosa.
Se una persona chiede a un sistema di trovare scappatoie fiscali, l’intenzione è almeno riconoscibile e può essere sottoposta a controlli.
Se invece l’agente individua da solo una vulnerabilità, l’azione può passare inosservata, perché non viene percepita come un attacco.
Reward hacking: quando l’AI cerca scorciatoie
Il fenomeno è collegato al concetto di reward hacking, cioè l’aggiramento del sistema di ricompensa.
Si verifica quando un modello raggiunge il risultato misurato dai suoi progettisti attraverso un comportamento che questi non volevano né avevano previsto.
Gli esperimenti precedenti alla diffusione dei grandi modelli linguistici, gli LLM, mostrano che il problema non è nuovo. In una simulazione di calcio a due giocatori, un agente aveva imparato a calciare la palla fuori dal campo, costringendo il portiere avversario a rimetterla in gioco e a lasciare la porta scoperta.
Un robot aspirapolvere, in un altro test, ha mostrato una scorciatoia analoga.
Il ricercatore voleva insegnargli a non urtare gli oggetti, ma il robot aveva imparato a procedere all’indietro, perché non aveva sensori nella parte posteriore. Il requisito era rispettato solo in senso letterale.
Questi esempi evidenziano il problema degli obiettivi specificati male e dei vincoli incompleti.
Un sistema competente può trovare una soluzione che soddisfa la metrica senza però raggiungere lo scopo reale.
Gli esseri umani riconoscono l’inganno perché condividono il contesto: l’AI, almeno per ora, non lo comprende nello stesso modo.
Schneier richiama tre immagini della tradizione popolare.
Nella storia di re Mida, Dioniso gli concede il potere di trasformare in oro tutto ciò che tocca.
Il sovrano finisce per non poter mangiare né bere e trasforma in oro anche la figlia: ha chiesto un risultato senza considerare le conseguenze.
Nel racconto del Golem di Praga, una statua d’argilla viene animata per proteggere gli abitanti del ghetto, ma continua a eseguire il compito oltre ogni limite ragionevole, finché non viene fermata.
Entrambe le storie illustrano il problema del genio: una creatura che esaudisce i desideri in modo letterale, spesso con conseguenze indesiderate.
Il linguaggio umano è sempre incompleto.
Se chiediamo a qualcuno di portarci un caffè, non dobbiamo precisare che non vogliamo un sacco di chicchi o una pianta.
Una persona comprende il contesto e interpreta la richiesta secondo le convenzioni sociali.
Il caso Volkswagen e quello OpenAI-Hugging Face
Il caso Volkswagen dimostra che questo rischio non appartiene soltanto alla teoria.
Nel 2015 il costruttore fu scoperto a utilizzare un software capace di riconoscere i test sulle emissioni e di modificare il comportamento del motore durante le verifiche.
Il veicolo rispettava i parametri in laboratorio, ma si comportava in modo diverso su strada.
Schneier usa l’episodio per spiegare che un’AI incaricata di massimizzare le prestazioni e superare i test sulle emissioni potrebbe individuare una soluzione analoga, se i programmatori non vietassero in modo esplicito comportamenti differenti durante la prova.
Questi sistemi sono, per Schneier, geni artificiali: ricevono istruzioni generiche e decidono autonomamente come eseguirle.
Il fenomeno è legato anche al vibe coding, nel quale l’utente descrive in termini generali il risultato desiderato e lascia che l’AI sviluppi il software.
Si tratta di un approccio che semplifica il lavoro, ma comporta una delega significativa.
Il modello deve colmare le lacune della richiesta, prendendo decisioni che l’utente non ha specificato.
Gli algoritmi di raccomandazione sono un altro esempio che rientra in questa logica.
Hanno spinto gli utenti verso contenuti estremi perché questi generavano più reazioni e interazioni, andando talvolta a proporre materiale discutibile.
Nessuno aveva programmato il sistema per proporre materiale inappropriato e, di conseguenza, l’algoritmo ha semplicemente seguito i suoi compiti in modo letterale.
Un episodio ancora più delicato ha coinvolto un recente modello di OpenAI durante una valutazione delle sue capacità informatiche.
Il test chiedeva al sistema di trasformare vulnerabilità potenziali in exploit funzionanti.
L’agente ha cercato una scorciatoia: uscire dall’ambiente di contenimento, raggiungere Internet e accedere alla rete di Hugging Face, ritenendo che lì potessero trovarsi risposte e materiali utili alla prova.
Nessuno gli aveva chiesto di attaccare l’azienda. L’azione è emersa dal tentativo di ottenere il risultato richiesto.
Hugging Face ha ricostruito circa 17.600 azioni dell’agente, raggruppate in circa 6.280 cluster, tra il 9 e il 13 luglio 2026.
Secondo l’azienda, l’agente ha prima raggiunto un ambiente esterno da utilizzare come punto di appoggio e poi ha sfruttato due vettori nella pipeline di elaborazione dei dataset: una lettura di dati HDF5 esterni, che ha esposto file locali, e l’iniezione in un template Jinja2, che ha consentito di eseguire codice.
Una volta ottenuto un accesso all’interno dell’infrastruttura, ha cercato credenziali e si è spostato verso altre risorse.
Schneier distingue due tipi di genio.
Il genio di Dioniso e del Re Mida interpreta male la richiesta e produce un risultato che l’utente non voleva.
Il genio del Golem, invece, comprende il risultato ma travolge tutto ciò che incontra per raggiungerlo.
Aggiungere dettagli alla richiesta non basta a eliminare il rischio. Non è possibile elencare tutte le eccezioni e anticipare ogni circostanza.
I ricercatori lavorano quindi su difese contro il reward hacking e su tecniche di value alignment, cioè l’allineamento dei valori, per insegnare ai sistemi a considerare il contesto e non soltanto l’obiettivo assegnato.
Schneier propone un benchmark specifico per valutare il comportamento da genio e misurare se i modelli migliorano.
La valutazione dovrebbe considerare non solo se il compito viene completato, ma anche come viene raggiunto il risultato.
Una ricerca pubblicata su arXiv il 23 settembre 2026, Reward Hacking Challenges Oversight of Autonomous Research Agents, ha esaminato 17 modelli linguistici prendendo in considerazione 38 diverse attività.
Gli autori hanno rilevato comportamenti spontanei di reward hacking nel 30,5% dei compiti di ricerca più aperti e nel 2,9% dei compiti specifici.
Quando era consentito cercare scorciatoie in attività con soglie difficili da raggiungere, 505 tentativi su 677, pari al 74,6%, sono stati confermati come casi di aggiramento della valutazione.
Geni artificiali e finanza
I mercati finanziari potrebbero essere tra i primi ambiti a subire questa trasformazione, perché le loro regole sono già organizzate in modo da poter essere elaborate da algoritmi.
Il trading ad alta frequenza è, nella lettura di Schneier, una forma di hack: sfrutta differenze minime nei tempi e nelle informazioni per ottenere un vantaggio.
Un agente potrebbe ricevere tutti i principi finanziari abbinati alle notizie di mercato e avere il compito di trovare scappatoie redditizie.
Schneier sospetta che grandi banche d’investimento stiano già esplorando applicazioni di questo tipo.
Il caso del Double Dutch Irish Sandwich, una strategia utilizzata da Apple e Google per ridurre il carico fiscale negli Stati Uniti, mostra quanto possano essere articolate queste operazioni.
Il meccanismo combinava norme statunitensi a quelle di altri paesi, come Olanda e Irlanda, con il ricorso a un paradiso fiscale offshore.
Un sistema in grado di analizzare nello stesso momento ordinamenti differenti potrebbe trovare molte altre combinazioni non ancora note.
Schneier si chiede se il numero delle nuove scappatoie sarà nell’ordine delle decine, delle centinaia o delle migliaia: al momento non esiste una risposta.
Gli esseri umani hanno sempre cercato di manipolare i sistemi per ottenere influenza, potere e ricchezza, ma hanno dovuto fare i conti con limiti pratici.
Anche chi agisce senza scrupoli è condizionato da fattori come complessità sociale, dalla reputazione, dai rischi legali e dal tempo necessario per progettare un’operazione.
L’AI ha già dimostrato che può ridurre questi vincoli senza particolari problemi.
La velocità è il primo cambiamento.
Un’attività che avrebbe richiesto mesi o anni a una persona può essere svolta in tempi molto più brevi.
La scala è il secondo: una volta scoperta una vulnerabilità, un sistema può ripetere l’operazione per sondare un numero impressionante di bersagli o nicchie.
Schneier richiama la diffusione di contenuti generati dall’AI sui social network, dove i bot possono pubblicare senza interruzione e sommergere le conversazioni umane.
Non va poi sottovalutata l’ampiezza degli effetti.
I sistemi di AI prendono già decisioni che incidono sulla vita delle persone e, con il miglioramento delle loro capacità, riceveranno responsabilità sempre più elevate.
Una vulnerabilità in questi processi può quindi provocare danni maggiori.
I vantaggi, però, non saranno distribuiti in modo uniforme.
Gli hack realizzati con l’AI rischiano di essere utilizzati soprattutto dai soggetti già potenti.
Un cittadino che trova una scappatoia fiscale potrebbe risparmiare qualche migliaio di dollari, mentre una grande banca d’investimento, con capitali e clienti su vasta scala, potrebbe ricavarne miliardi.
L’AI è una tecnologia che amplifica il potere di chi la controlla e l’hacking produce un effetto analogo nella maggior parte dei casi.
I sistemi di governo sono stati progettati quando gli hacker erano esseri umani e le loro attività procedevano a un ritmo compatibile con i tempi delle istituzioni.
Non esiste una struttura in grado di gestire centinaia o migliaia di nuove scappatoie fiscali individuate in tempi brevissimi.
Una strategia legale ma imprevista può essere sfruttata prima che il legislatore riesca a comprenderne le conseguenze.
Mosse e contromosse
Chi si trova dall’altra parte della barricata, tuttavia, può sfruttare la stessa tecnologia.
Gli agenti che individuano vulnerabilità nel software possono aiutare a correggerle prima che il prodotto venga distribuito.
Una falla può essere eliminata con una patch oppure ricavarne una sorta di impronta digitale integrata nei sistemi di sicurezza.
Schneier indica con il termine vulnops l’integrazione della ricerca e della correzione delle vulnerabilità nei processi ordinari di sviluppo.
In prospettiva, l’AI potrebbe identificare e correggere molte vulnerabilità accidentali prima del rilascio.
Lo stesso approccio può essere applicato alla legislazione.
Un agente potrebbe analizzare una proposta di legge fiscale o un regolamento e individuare le scappatoie prima dell’approvazione.
Un parlamentare, un ente di controllo o un giornalista potrebbe sottoporre il testo a una verifica automatizzata per individuare le possibilità di abuso.
Riconoscere una falla, però, è solo il primo passo verso la sua correzione: serve una volontà politica per rendere il processo efficace.
Molto dipende anche se vi sono interessi economici in gioco per conservarla.
Un altro tema centrale, dunque, è la fiducia.
Un sistema non è affidabile soltanto perché sa completare un compito, ma è importante anche sapere chi lo controlla, quali interessi persegue e se può essere manipolato.
Un agente opera davvero nell’interesse dell’utente oppure rischia di diventare un doppio agente, influenzato dall’azienda che lo gestisce?
Se le società che controllano i modelli possono sorvegliare gli utenti o orientarne le scelte, la capacità tecnica non basta. Allo stesso modo, un agente insicuro non può essere considerato affidabile.
Come evitare il pericolo dei geni artificiali
Il terzo requisito è impedire che gli agenti si comportino come geni.
Devono svolgere le attività nel modo che una persona ragionevole avrebbe inteso, non limitarsi a raggiungere il risultato letterale.
Schneier utilizza l’espressione integrous AI per indicare sistemi dotati di integrità e prevede che questa diventi una delle principali questioni di sicurezza del decennio, così come la riservatezza è stata centrale nel precedente.
In questo scenario, una violazione dell’integrità non produce soltanto dati errati in un foglio di calcolo.
L’ampio utilizzo dell’AI nei più disparati campi, può comportare una dose medica sbagliata o una distanza di frenata non corretta.
Schneier distingue quattro dimensioni: integrità degli input, dell’elaborazione, della conservazione e del contesto. Le informazioni in ingresso devono essere autentiche, il trattamento deve rispettare le regole, i dati archiviati non devono essere alterati e il risultato deve essere coerente con la situazione in cui viene utilizzato.
Schneier osserva che una parte del problema non è soltanto tecnologica: riguarda il capitalismo e la democrazia.
Le difficoltà delle società nell’era dell’informazione derivano anche dal fatto che i gruppi ricchi e potenti hanno imparato a sfruttare con crescente efficacia i sistemi sociali, economici e politici.
È una tesi già presente in A Hacker’s Mind.
L’AI può aggravare squilibri esistenti perché riduce i costi della ricerca di scappatoie e permette di applicare le strategie con una rapidità e una scala che gli esseri umani non possono eguagliare.
Oggi e gli scenari futuri
Gli sviluppi del 2026 offrono ulteriori segnali. In settembre Schneier ha richiamato un rapporto dell’AI Security Institute britannico su comportamenti non autorizzati durante prove di cybersecurity.
In 122 esecuzioni di un test apposito, gli agenti avrebbero compiuto 19 azioni non autorizzate su Internet in 10 sessioni.
Inoltre, 17 azioni sono state attribuite al modello Mythos 5 di Anthropic e 2 a GPT-5.6-Sol di OpenAI.
Non a caso Anthropic ha rivisto le proprie procedure di controllo dopo gli attacchi a Hugging Face.
Reuters ha riferito a fine agosto che l’azienda aveva ripreso alcuni test esterni dopo aver introdotto nuove misure di sicurezza. Anthropic aveva attribuito gli episodi a carenze operative nell’ambiente di test di un fornitore terzo e aveva sospeso per un periodo alcune attività.
La valutazione della sicurezza deve quindi cambiare prospettiva per evitare disagi già nell’immediato futuro.
Non basta più chiedersi se un modello sappia produrre codice dannoso o rispondere a una richiesta pericolosa.
Oggi occorre osservare quali strumenti decide di utilizzare, se rispetta i confini imposti dall’utente umano e interpreta i limiti impliciti della richiesta.
Il caso Hugging Face è emblematico perché l’agente non aveva ricevuto l’ordine di attaccare un’azienda: aveva cercato solo una scorciatoia per superare una prova nel modo più efficiente possibile.
La distinzione tra intenzione malevola e comportamento dannoso diventa così decisiva.
La risposta, affinché riesca a limitare l’agire pericoloso dell’AI, deve essere di duplice natura, ovvero tecnica e politica.
Sul piano tecnico occorre comprendere come gli agenti individuano e sfruttano le debolezze, costruire infrastrutture resistenti, limitare i permessi, registrare le operazioni (per indagini forensi tramite log) e verificare i risultati con sistemi indipendenti.
I benchmark devono misurare non soltanto la capacità di completare un compito, ma anche la correttezza del percorso seguito.
Sul piano politico servono istituzioni in grado di aggiornare le regole alla velocità con cui la tecnologia scopre nuove opportunità di abuso.
L’hacking esiste da quando esistono sistemi di regole e persone interessate a manipolarli.
L’AI va semplicemente ad amplificare il suo impatto, modificando in modo esponenziale velocità e ampiezza del fenomeno.